KI-Sichtbarkeits-Tools 2026: Was Sie prüfen sollten, bevor Sie zahlen
Wie die meisten KI-Sichtbarkeits-Tools still einschränken, was Sie tracken können — und was Sie vor dem Kauf fragen sollten. Ein Käuferführer mit verifizierten Preisen.
Der Markt für KI-Sichtbarkeits-Tools hat ein spezifisches Problem: Er entwickelt sich schnell genug, dass die meisten Käufer noch nicht wissen, welche Fragen sie stellen sollen. Anbieter wissen das, und manche nutzen es aus.
Ich habe die letzten Monate damit verbracht, diese Plattformen zu testen — nicht Demo-Calls anzuschauen, sondern sie tatsächlich auf Kundenkonten laufen zu lassen, zu prüfen, ob die Zahlen stimmen, und Fragen zu stellen, die in Verkaufsgesprächen nicht auftauchen. Das sind meine Erkenntnisse.
Das Abrechnungsproblem, das kein Anbieter bewirbt
Bevor Sie Features vergleichen, verstehen Sie, wie jedes Tool abrechnet. Das Preismodell bestimmt, was Sie sich leisten können zu tracken — und das bestimmt, was Sie tatsächlich über Ihre KI-Suchpräsenz wissen.
Drei Modelle dominieren den Markt.
Prompt-basierte Abrechnung. Sie kaufen ein Prompt-Kontingent. 50 auf Einsteigerniveau, vielleicht 150 im nächsten Tier, 350 wenn Sie bereit sind, dafür zu zahlen. Jede Anfrage, die Sie monitoren möchten, verbraucht einen Prompt. Wollen Sie mehr kaufreisebezogene Fragen tracken? Mehr Prompts. Wollen Sie die Liste aktualisieren, wenn sich das KI-Suchverhalten ändert? Sie schöpfen aus demselben Kontingent.
Die praktische Konsequenz: Sie beginnen, Ihr eigenes Tracking zu rationieren. Sie wählen 50 Prompts und hoffen, dass es die richtigen sind. Sie lassen die Long-Tail-Anfragen weg. Sie aktualisieren die Liste nicht, wenn sich etwas am Markt verändert. Am Ende haben Sie ein ordentliches Dashboard, das widerspiegelt, was Sie sich leisten konnten zu tracken — nicht das, was tatsächlich passiert.
Engine-basierte Abrechnung. Viele Tools inkludieren 3–4 KI-Engines im Basispaket und berechnen den Rest extra. Claude kostet oft Aufpreis. Gemini ist möglicherweise gesperrt. Copilot ist manchmal in Standard-Plänen gar nicht verfügbar.
OtterlyAI berechnet je nach Plan $29–$439 extra pro Monat für Claude-Tracking. Peec AI gibt Ihnen drei der sechs unterstützten Engines pro Plan — jede weitere Engine kostet $30–$140 extra pro Monat on top. Wenn Sie einen Listenpreis sehen, müssen Sie erst die Engine-Rechnung aufmachen, bevor Sie ihn akzeptieren.
Abrechnung pro Domain oder Marke. Semrush’s AI Visibility Toolkit berechnet $99 pro Domain und Monat. Transparent und planbar bei einer Marke; brutal, wenn Sie das über eine Agentur-Kundenliste multiplizieren.
Was BYOK wirklich ändert
CrunchJunkie geht die ganze Preisfrage anders an. Statt API-Aufrufe in ein Prompt-Kontingent zu verpacken und mit Aufschlag pauschal zu berechnen, lässt es Sie eigene API-Keys verbinden. Ihre Anfragen gehen direkt an OpenAI, Google, Anthropic und die anderen Anbieter — Sie zahlen diese zu Einkaufspreisen. Die Plattform berechnet ein Abonnement auf Basis der Anzahl getrackter Marken, nicht der Prompt-Menge.
Das Ergebnis: kein Prompt-Limit. Alle zehn Engines — ChatGPT, Gemini, Perplexity, Claude, Google AI Overviews, Google AI Mode, Microsoft Copilot, Grok, Meta AI und DeepSeek — sind in jedem Plan ab der untersten Stufe enthalten. Keine Engine-Add-ons.
Das verändert die Anreizstruktur konkret. Mit einem Prompt-Limit haben Sie einen Grund, weniger Anfragen zu tracken als Sie sollten. Mit BYOK ohne Limit tracken Sie, was tatsächlich sinnvoll ist.
So sehen die Jahreskosten bei einer konsistenten Konfiguration — 50 Prompts pro Marke, 5 Engines, wöchentliches Scannen, Jahresabrechnung — für Tools mit öffentlichen Preisangaben aus:
| Tool | Abrechnung | 1 Marke / J. | 5 Marken / J. | 10 Marken / J. |
|---|---|---|---|---|
| CrunchJunkie | nur Marken | $601 | $2,873 | $6,105 |
| LLM Pulse | Prompts + Projekt | $529 | $3,229 | $7,763 |
| Peec AI | Prompts + Engine | $1,932 | $9,636 | — |
| Semrush | Domain | $1,908 +Abo | $9,540 +Abo | $19,080 +Abo |
| OtterlyAI | Prompts + Engine | $2,508 | $4,884 | $7,260 |
| Scrunch * | Marken-Workspace | ~$3,000 | — | — |
| Evertune | Flatrate (Prompt-Vol.) | $9,600 | $9,600 | $9,600 |
| Ahrefs † | Basis + Add-on | $9,936 +Abo | $9,936 +Abo | $9,936 +Abo |
| GEOly ‡ | Tier + Engine-Gate | $11,988 | $11,988 | — |
So lesen Sie diese Tabelle
Jedes Tool ist bei identischer Konfiguration bewertet, damit die Zahlen direkt vergleichbar sind: 50 Prompts pro Marke, 5 KI-Engines, wöchentliches Scannen, Jahresabrechnung. Nur die Plankosten bei dieser genauen Konfiguration werden gezeigt — kein Rosinenpicken bei günstigeren Tiers, die die Anforderungen nicht erfüllen würden.
CrunchJunkies Zahl ist das Plattform-Abonnement plus geschätzte BYOK-API-Kosten (was Sie OpenAI, Google, Anthropic usw. direkt zahlen). Die Schätzung ist konservativ — die tatsächlichen API-Kosten bei 50 Prompts/Woche sind typischerweise niedriger, und Sie sehen genau, was Sie ausgeben, weil Sie die Anbieter direkt zu Einkaufspreisen ohne Aufschlag zahlen.
Ein Strich (—) bedeutet, dass kein Self-Serve-Plan diese Konfiguration abdeckt — Sie bräuchten ein Custom-Enterprise-Angebot.
* Scrunch-Preise ändern sich häufig; Angabe vom August 2026 — vor dem Zitieren auf scrunch.com prüfen.
† Ahrefs: Basisplan ($129/Mo.) + Brand-Radar-Add-on mit allen Engines ($699/Mo.). Das enthaltene Brand-Radar-Prompt-Kontingent umfasst nur 5–20 Prompts — das Add-on ist erforderlich, um 50+ zu tracken.
‡ GEOly: 5-Engine-Abdeckung erfordert den $999/Mo.-Tier; max. 5 Marken. 10-Marken-Konfiguration nicht im Self-Serve-Plan verfügbar.
Mitbewerberpreise von öffentlichen Preisseiten verifiziert, wo zugänglich; andernfalls aus sekundären Quellen. Preise ändern sich häufig — vor dem Abschluss prüfen.
Ein ehrlicher Vorbehalt, den diese Tabelle nicht verstecken sollte: LLM Pulse ist bei einer Marke günstiger (∼$529/Jahr vs. CrunchJunkies ∼$601). Wenn Sie ein kleines Programm betreiben, keine Multi-Engine-Abdeckung brauchen und mit einem Prompt-Limit leben können, ist es neben CrunchJunkie einen Blick wert. LLM Pulse setzt Prompt-Limits und behandelt Copilot und Claude als kostenpflichtige Add-ons — bei einer Marke mit begrenzten Prompts und wenigen Engines beißen diese Einschränkungen möglicherweise nicht.
Ab fünf Marken dreht sich die Rechnung um. Ab zehn Marken kann Peec AI die Konfiguration nicht einmal ohne Custom-Enterprise-Gespräch anbieten. Semrush läuft bei $19.000+ pro Jahr, bevor das erforderliche Basis-Abonnement hinzukommt.
CrunchJunkie-Pläne (EUR, Jahresabrechnung): Solo €9/Monat (1 Marke) · Starter €39/Monat (5 Marken) · Pro €99/Monat (20 Marken) · Agency €149/Monat (40 Marken), plus Ihre BYOK-API-Kosten.
Warum Sichtbarkeits-Prozentsätze ohne Stichprobengrößen lügen
Das Problem mit KI-Antwortsystemen, das die meisten Sichtbarkeits-Dashboards still übergehen: Sie sind nicht-deterministisch.
Führen Sie denselben Prompt zweimal in ChatGPT aus, mit demselben Account, fünf Minuten auseinander. Sie können unterschiedliche Marken in der Antwort, unterschiedliches Framing, unterschiedliche Quellenlisten erhalten. Eine SparkToro-Studie fand weniger als 1 % Überschneidung zwischen ChatGPT und Google AI, die in zwei separaten Antworten auf dieselbe Anfrage dieselbe Markenliste nannten.
Das ist kein Randfall. So funktionieren diese Systeme — sie samplen aus Wahrscheinlichkeitsverteilungen, aktualisieren sich kontinuierlich, personalisieren basierend auf Kontext. Jede KI-Sichtbarkeitszahl, die Sie sehen, basiert auf einer Stichprobe von Antworten, nicht einer vollständigen Erhebung.
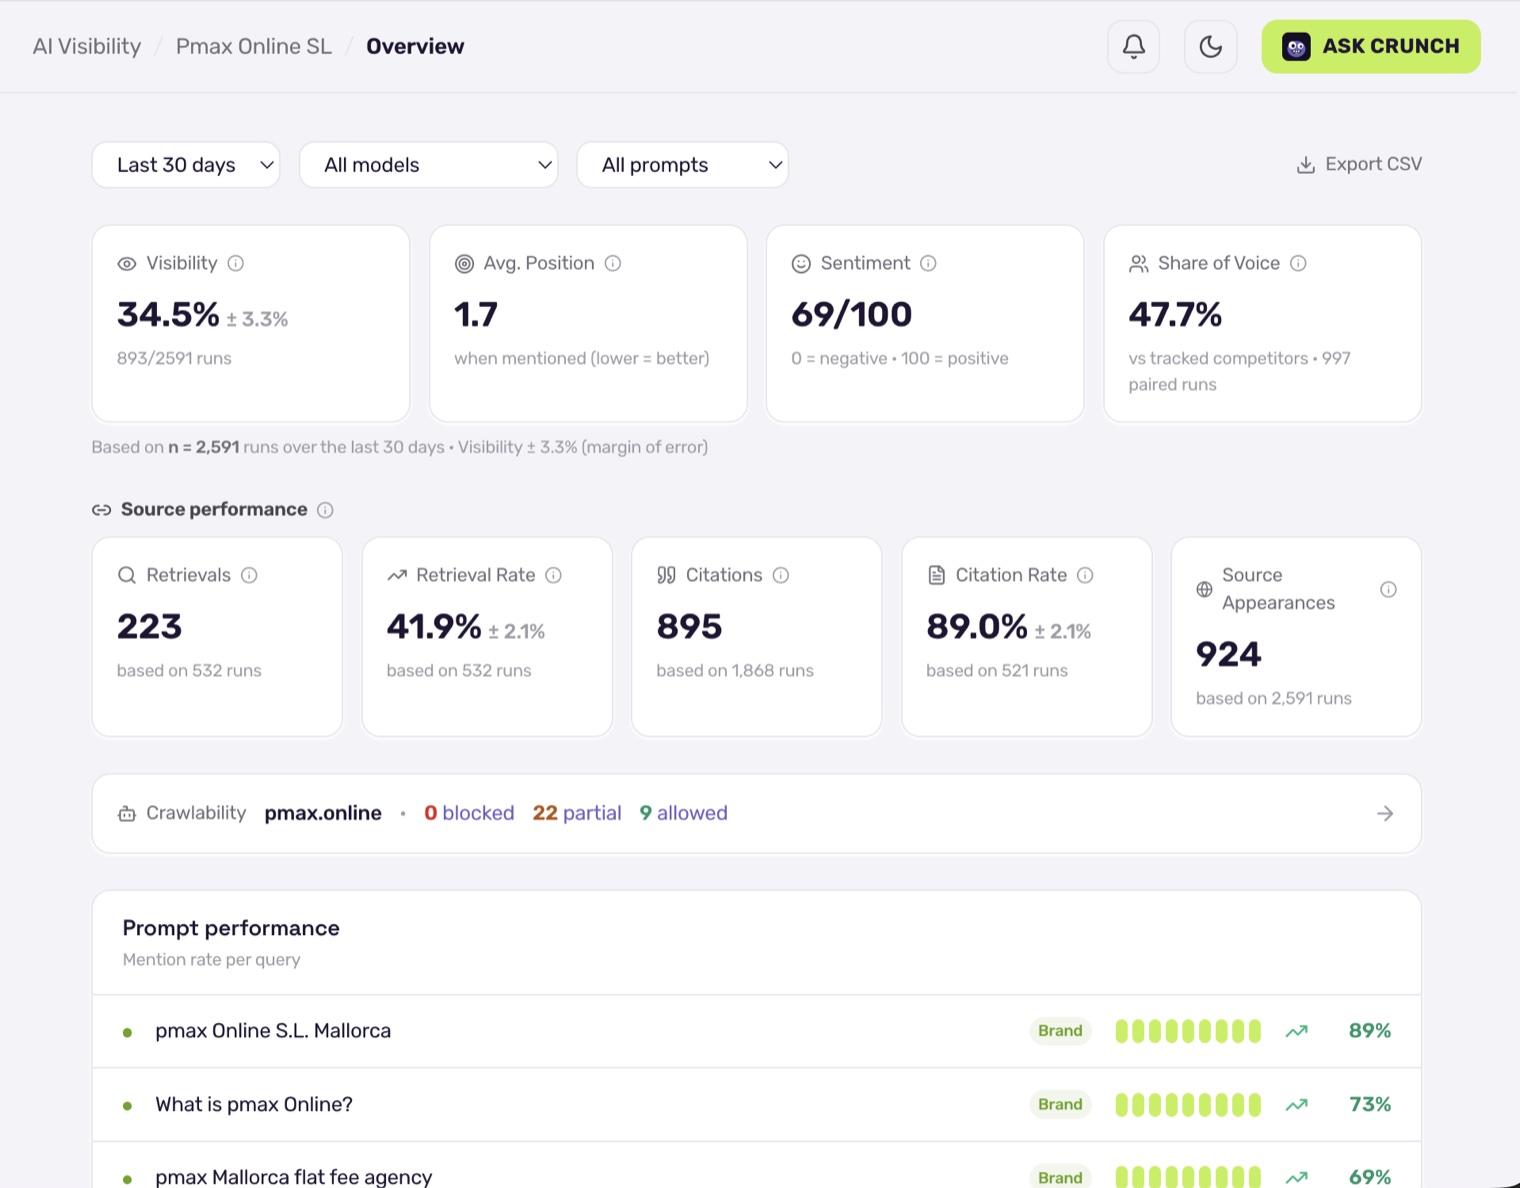
Wenn ein Tool Ihnen „34 % Sichtbarkeit“ zeigt — was bedeutet das genau? Haben sie den Prompt einmal ausgeführt? Dreimal? Zwanzig Mal? Ist 34 % eine stabile Messung mit schmalem Fehlerbereich, oder ein einzelner Datenpunkt, der überall zwischen 10 % und 60 % hätte landen können?
Die meisten Tools sagen es Ihnen nicht. Sie zeigen die Zahl.
CrunchJunkie führt jeden Prompt mehrfach aus und zeigt Stichprobengröße und Fehlerbereich neben jeder Sichtbarkeitszahl. Die Produktphilosophie ist explizit: Eine einzelne KI-Antwort ist eine Stichprobe, kein Trend. Jede Metrikänderung wird gegen ihren Fehlerbereich abgewogen, bevor sie als handlungsrelevante Bewegung gilt.
Das spielt für Agenturen die größte Rolle. Wenn Sie einem Kunden KI-Sichtbarkeit berichten und die Zahl um vier Punkte fällt, müssen Sie wissen, ob das ein echtes Signal ist oder Rauschen. Ohne Stichprobengröße und Fehlerbereiche zeigen Sie einem Kunden ein Diagramm, das möglicherweise nichts bedeutet. Mit ihnen können Sie mit Gewissheit sagen, ob sich wirklich etwas bewegt hat.
Eine Metrik, die kein anderes Tool erfasst: Follow-up Survival
Überlegen Sie, wie Menschen KI tatsächlich für kommerzielle Entscheidungen nutzen.
Jemand fragt ChatGPT: „Was sind die besten Projektmanagement-Tools für verteilte Teams?“ Ihre Marke erscheint. Sichtbarkeit: erfasst. Gewonnen.
Aber die Unterhaltung geht weiter. Die Nachfrage: „Welches davon eignet sich am besten für ein Team unter fünfzehn Personen, das nicht pro Nutzer zahlen möchte?“
Ihre Marke verschwindet.
Sie haben die breite Discovery-Anfrage gewonnen und verloren, sobald eine echte Einschränkung angewendet wurde. Das Standard-Sichtbarkeits-Dashboard hat das nie erfasst — es hat Turn 1 gemessen und aufgehört.
CrunchJunkie nennt das Follow-up Survival: eine Multi-Turn-Metrik, die misst, ob eine Empfehlung standhält, wenn ein Käufer seine Frage in derselben Unterhaltung eingrenzt. Die Plattform führt den Discovery-Prompt aus, erfasst, welche Marken erscheinen (Turn 1), sendet eine konfigurierte Folgefrage in derselben Unterhaltung (Turn 2) und misst, welche Marken die Verfeinerung überstehen.
Kein anderes Tool in der Kategorie produktisiert das. Es ist als Opt-in-Pilotfeature auf bezahlten Plänen verfügbar und kostet ungefähr doppelt so viel pro Prompt — weil es zwei Konversations-Turns statt eines benötigt.
Ein Design-Detail, das wichtig ist: Die Folgefrage wird pro Prompt konfiguriert, nicht generisch angewendet. Ein Narrower, der nach „beste Projektmanagement-Tools für verteilte Teams?“ Sinn ergibt, ist nach „beste Espressomaschinen unter €200“ sinnlos. CrunchJunkie erfordert eine per-Prompt-Folgefrage, bietet einen KI-entworfenen Vorschlag zum Überprüfen und Bearbeiten an, und erfasst den genauen verwendeten Text bei jedem Run als Nachweis — damit Sie genau wissen, was gefragt wurde, und Ergebnisse über Zeit vergleichen können, weil die Frage konsistent bleibt.
Wenn Ihre Käufer Multi-Turn-KI-Unterhaltungen zur Recherche nutzen — und B2B-Käufer tun das zunehmend — ist das Überleben in Turn 2 kommerziell aussagekräftiger als Sichtbarkeit in Turn 1.
GEO-Audits: warum die Evidenzbasis zählt
Jedes KI-Sichtbarkeits-Tool enthält etwas, das sich GEO-Audit nennt — eine Diagnose, wie bereit Ihre Website ist, von KI-Engines gecrawlt und zitiert zu werden. Die Qualität dieser Audits variiert enorm, aus einem Grund, der erst offensichtlich wird, wenn man genauer hinsieht.
Die ehrliche Wahrheit zur KI-Suchoptimierung: Wir haben noch keine jahrzehntelange kontrollierte Evidenzbasis. Wir haben einige Peer-Review-Forschungen, veröffentlichte Dokumentationen von Crawler-Anbietern und viel „das könnte helfen“-Logik, die niemand tatsächlich gemessen hat. Die guten Audit-Tools sind explizit darüber, in welche Kategorie jeder ihrer Checks fällt. Die schlechten nicht.
CrunchJunkie strukturiert seinen Audit um eine formale Evidenzleiter:
- Research — durch Peer-Review-Messung von Zitatraten-Effekten belegt
- Documented — veröffentlichtes Plattformverhalten der Crawler-Anbieter selbst
- Convention — entstehende Praxis, noch nicht belegt als von KI-Engines konsumiert
- Heuristic — sinnvoller Proxy, kein direkter Nachweis
Die Gewichtung jedes Checks im Gesamtscore skaliert mit seinem Evidenzlevel. Heuristiken können eine Kategorie nicht dominieren. Convention-basierte Checks tragen bewusst geringere Gewichtung.
Ein konkretes Beispiel: llms.txt. Das war ein stark gehyptes Thema. CrunchJunkie gibt ihm eine Gewichtung von 5 von 100 im Gesamtscore — bewusst niedrig. Die quartalsweise Forschungsüberprüfung ergab, dass etwa 97 % der veröffentlichten llms.txt-Dateien null Crawler-Anfragen erhalten, und Claude Code ist der einzige bestätigte reale Leser des Standards im Maßstab. Googles eigene Leitlinien, aktualisiert im August 2026, stellen explizit fest, dass Google Search llms.txt ignoriert.
Ein Audit-Tool, das llms.txt mit 15 oder 20 Punkten bewertet, sagt Ihnen, dass es mehr bedeutet als die Evidenz stützt. Das bläht Ihren Score auf für etwas, das Ihnen wahrscheinlich noch nicht hilft, und begräbt die Checks, die tatsächlich relevant sind.
Auf der Inhaltsseite werden die Checks mit echtem Gewicht durch die KDD-2024-Studie „GEO: Generative Engine Optimization“ (Aggarwal et al., Princeton/IIT Delhi) gestützt, die tatsächliche Zitatraten-Effekte gemessen hat. Zitate im Content verbesserten Zitatraten um 27,8 %. Belegte Statistiken: +25,9 %. Autoritative externe Zitate: +24,9 %.
Der Audit umfasst fünf Kategorien — Crawler-Zugang (Gewichtung 30), Content-Zugänglichkeit (30), strukturierte Daten (20), technische SEO-Hygiene (15) und llms.txt (5) — und erzeugt einen 0–100-Gesamtscore. Diagnostisch, keine Garantie, und ehrlich darüber, was er nicht weiß.
Eigene Off-Site-Zitationen
Wenn eine KI-Engine Ihre Marke zitiert, zieht sie oft aus Inhalten, die außerhalb Ihrer Hauptdomain leben: einem YouTube-Kanal, einer LinkedIn-Unternehmensseite, einem Substack-Beitrag, einem Reddit-Thread, an dem Sie teilnehmen.
„Brand Radar“-Tools aus dem traditionellen SEO lösen das per Web-Index-Matching — sie crawlen das offene Web und suchen nach Ihrem Markennamen. Das ist breite Abdeckung, aber rauschig: Sie krediten Ihnen Erwähnungen, die Sie nicht kontrollieren, Inhalte, die andere über Sie geschrieben haben, und Markennamen-Verwechslungen.
CrunchJunkies Off-Site-Zitations-Tracking funktioniert umgekehrt. Sie deklarieren Ihre eigenen Kanäle — youtube.com/@ihreMarke, linkedin.com/company/ihreMarke, Ihr Substack, Ihr Medium-Handle. Die Plattform schreibt Ihnen eine Zitation nur zu, wenn sie auf einer URL liegt, die einem deklarierten Kanal entspricht, mit handle-präzisem Matching. Ein YouTube-Video eines anderen Erstellers mit Ihrem Markennamen im Titel zählt nicht.
Die Konsequenz ist eine wesentlich handlungsrelevantere Ansicht. Sie sehen exakt, welche Ihrer eigenen Kanäle KI-Engines für welche Themen verwenden, und wo Sie Lücken haben. Das lässt sich direkt in Content-Investitionsentscheidungen übersetzen: nicht „bauen Sie eine LinkedIn-Präsenz auf“ (die haben Sie vielleicht schon und sie funktioniert), sondern „stärken Sie Ihre YouTube-Abdeckung für diesen spezifischen Themencluster“.
Wann CrunchJunkie nicht die richtige Wahl ist
Ein Tool-Leitfaden, der das nicht sagt, ist ein Verkaufspitch.
Bei einer Marke mit knappem Budget: LLM Pulse unterbietet CrunchJunkie auf Einzelmarken-Niveau. Wenn Sie ein kleines Programm betreiben, keine Multi-Engine-Abdeckung brauchen und mit einem Prompt-Limit leben können, ist es neben CrunchJunkie einen Blick wert.
Wenn Sie SEO und KI-Sichtbarkeit in einer Plattform benötigen: Semrush’s AI Visibility Toolkit sitzt in einer vollständigen SEO-Suite — Keyword-Recherche, Backlink-Analyse, Rank-Tracking, Site-Audits. Wenn Ihr Team bereits in Semrush arbeitet und KI-Sichtbarkeit ohne ein separates Tool möchte, hat diese Integration echten Wert, auch zum höheren Per-Domain-Preis. CrunchJunkie macht kein traditionelles Rank-Tracking. Es ist zweckgebaut für KI-Sichtbarkeit.
Wenn Sie alles vollständig verwaltet möchten: Das BYOK-Modell erfordert das Einrichten von API-Keys bei einzelnen Anbietern. Für Teams, die eine vollständig verwaltete Option bevorzugen, bietet CrunchJunkie das ebenfalls an — der Preisvorteil ist aber am größten bei BYOK.
Das ehrliche Fazit
Die meisten KI-Sichtbarkeits-Tools 2026 wurden für den Einzelmarken-Fall entwickelt und passen ihre Preise und Architektur unbeholfen für Multi-Marken-Nutzung an. Engine-Gating und Prompt-Limits sind die Art, wie sie Kosten verwalten, die sie nicht transparent an Sie weitergeben können.
CrunchJunkie wurde mit Multi-Marken-Tracking als First-Class-Case gebaut. BYOK bedeutet, Ihre Kosten skalieren linear und transparent mit der tatsächlichen Nutzung. Kein Prompt-Rationieren, keine Engine-Add-ons, keine Kontakt-Sales-Mauer ab fünf Kunden.
Was es in der Praxis unterscheidet, hat weniger mit Feature-Listen zu tun und mehr mit intellektueller Ehrlichkeit: Follow-up Survival, weil Empfehlungsbeständigkeit unter Verfeinerung kommerziell wichtiger ist als Headline-Sichtbarkeit; Stichprobengrößen und Fehlerbereiche, weil KI-Antworten volatil sind; ein evidenzbasierter Audit, weil nicht alles, was Anbieter als „GEO-Signal“ bezeichnen, tatsächlich gemessen wurde.
Das sind die Dinge, die bestimmen, ob Sie darauf eine Reporting-Praxis aufbauen können — und ob das, was Sie Kunden zeigen, etwas bedeutet.
Preise verifiziert August 2026 von öffentlichen Preisseiten und für CrunchJunkie direkt aus dem Produktionscode. Mitbewerberpreise gegen öffentliche Preisseiten verifiziert, wo zugänglich; andernfalls aus sekundären Quellen. Preise in dieser Kategorie ändern sich häufig — vor dem Abschluss prüfen.
Möchten Sie wissen, wie Ihre Marke in der KI-Suche abschneidet? Schildern Sie uns kurz Ihre Situation — wir melden uns innerhalb eines Werktages. Das erste Gespräch: 30 Minuten, auf unsere Rechnung.
Weiterlesen: Was ist ein GEO-Audit? · Perplexity-Sichtbarkeit · Unser KI-Sichtbarkeits-Service